AI 治理框架是组织用于识别、评估、监测和处置人工智能风险的制度化工具集,目前已形成一个从价值原则、国际条约、法律法规、标准认证到自愿框架与技术工具的多层生态。其中,美国国家标准与技术研究院(NIST)发布的《人工智能风险管理框架》(AI RMF 1.0)是全球引用最广的自愿性框架:它以 GOVERN(治理)、MAP(映射)、MEASURE(测量)、MANAGE(管理) 四大功能为骨架,细分为 19 个类别、72 个子类别,并锚定七大"可信 AI"特征;2024 年 7 月又发布《生成式 AI Profile》(NIST AI 600-1),补充了幻觉(confabulation)、提示注入、知识产权等 12 类生成式 AI 特有风险。与之并列的关键框架包括:可认证的 ISO/IEC 42001 AI 管理体系标准、具有强制法律效力的欧盟《人工智能法》、政府间共识性的 OECD《AI 原则》,以及中国以算法备案、内容标识和《人工智能安全治理框架》为抓手的监管体系。本文以 NIST AI RMF 为切入点,系统梳理全球主要 AI 治理框架的结构、约束力、相互关系与落地路径,并给出企业选型与实施建议。截至 2026 年 8 月,全球 AI 治理正呈现三个显著趋势:从"软法"走向"硬法"、从内容生成风险走向智能体(Agentic AI)行为风险、从框架采纳走向运行时的持续执行。
1. 什么是 AI 治理框架:概念与类型学
AI 治理框架(AI Governance Framework)泛指一套帮助组织以可信、负责任的方式开发、采购、部署和运营人工智能系统的原则、流程、控制与问责机制。它要回答的核心问题包括:谁对 AI 系统的后果负责、如何识别和度量 AI 特有的风险(如幻觉、偏见、提示注入、数据漂移)、在什么阈值下允许系统上线、出现事故后如何响应与追溯。与面向确定性软件的传统 IT 治理不同,AI 系统的输出具有概率性、依赖会随时间漂移的数据、失败模式难以预测且难以穷举测试,这使得专门面向 AI 的风险管理框架成为必需。
从约束力与功能定位看,当前全球 AI 治理工具大致可分为六个层次,理解这一分层是阅读本文后续内容的基础:
| 层次 | 约束力 | 代表性框架/文件 | 核心作用 |
|---|---|---|---|
| 价值原则层 | 无(政府间共识) | OECD《AI 原则》(2019/2024)、UNESCO《AI 伦理建议书》(2021)、G7 广岛进程行为准则(2023) | 提供"可信 AI"的共同词汇与价值底座 |
| 国际条约层 | 约束缔约国 | 欧洲委员会《AI 框架公约》(CETS 225,2024) | 首部具法律约束力的国际 AI 条约,确立人权基线 |
| 法律法规层 | 强制、可处罚 | 欧盟《人工智能法》(2024)、韩国《AI 基本法》(2026 生效)、中国《生成式人工智能服务管理暂行办法》(2023)、美国科罗拉多州 SB 24-205 等 | 规定市场准入条件、法定义务与罚则 |
| 标准与认证层 | 自愿采用、可第三方认证 | ISO/IEC 42001(AI 管理体系)、ISO/IEC 23894(AI 风险管理)、ISO/IEC 42005(影响评估)、中国 TC260 系列国家标准 | 把治理要求转化为可审核、可认证的管理体系 |
| 自愿框架层 | 自愿,常被采购/诉讼"准强制化" | NIST AI RMF 1.0+生成式 AI Profile、新加坡《AI 治理示范框架》、英国"促进创新"五原则、中国《人工智能安全治理框架》1.0/2.0 | 提供结构化的风险管理方法论与最佳实践 |
| 技术工具层 | 自愿 | AI Verify(新加坡)、OWASP LLM Top 10、MITRE ATLAS、Gartner AI TRiSM、C2PA 内容溯源 | 把治理原则落实为可运行的测试、监测与控制 |
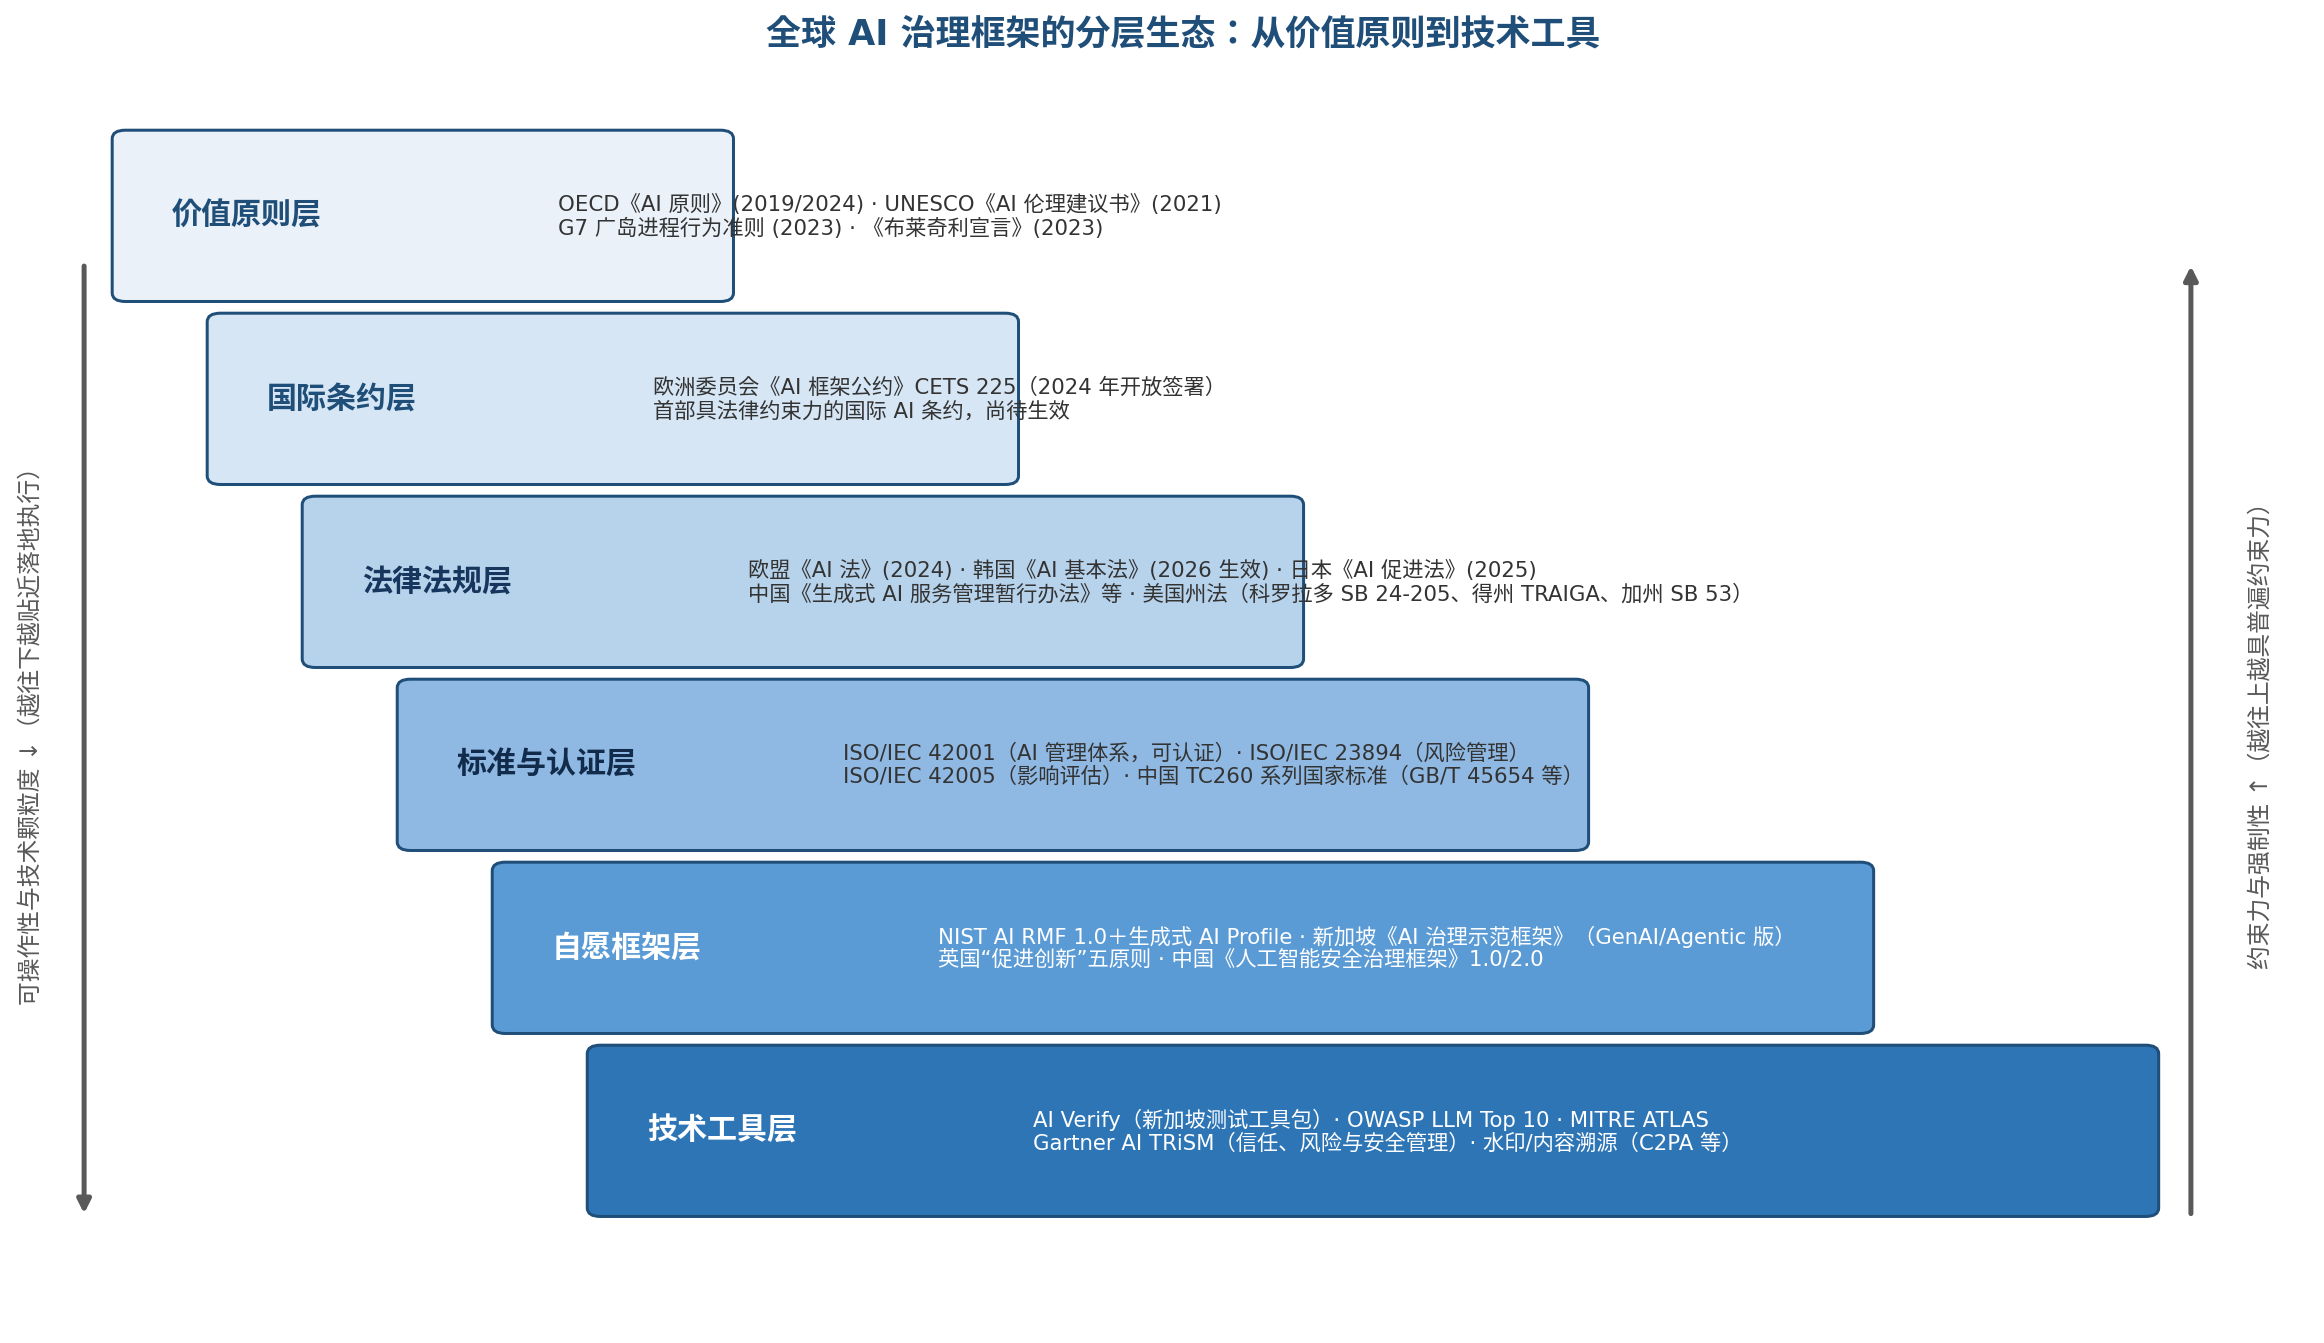
这张分层图揭示了一个重要的行业现实:没有任何单一框架能够覆盖全部需求。价值原则层(如 OECD 原则)共识最广但不可执行;法律法规层(如欧盟 AI 法)有强制力但只管辖特定辖区;自愿框架层(如 NIST AI RMF)提供了最细颗粒度的风险管理方法论,但依赖组织自觉;技术工具层则决定了治理是"纸面合规"还是"运行时执行"。成熟组织的典型做法是组合使用:以 NIST AI RMF 或 ISO/IEC 42001 搭建内部治理骨架,用法规映射(crosswalk)满足各辖区合规义务,再用技术工具实现持续监测与证据留存。后文将分别展开。
需要特别指出的是"自愿"二字的相对性。以 NIST AI RMF 为例,它在美国联邦层面无法律强制力,但美国联邦采购规则、多个州法(如科罗拉多州《人工智能法》将其作为"积极抗辩"依据)、行业监管指引(如金融业的模型风险管理)都越来越多地引用它,使其事实上成为一种"准合规基线"。类似地,ISO/IEC 42001 虽为自愿标准,却正迅速成为企业采购问卷和跨境合同中的"治理护照"。
2. NIST AI RMF 深度解析
2.1 制定背景与法律渊源
NIST《人工智能风险管理框架》(AI Risk Management Framework, AI RMF 1.0,正式编号 NIST AI 100-1)于 2023 年 1 月 26 日正式发布。其法律渊源是《2020 年国家人工智能倡议法案》(National AI Initiative Act of 2020)——美国国会要求 NIST 牵头制定一套面向全社会的 AI 风险管理自愿框架。整个制定过程遵循 NIST 典型的共识驱动、公开透明模式,历时约 18 个月,收到来自产业界、学术界、公民社会和政府机构 240 多个组织提交的约 400 组正式意见,这使它成为少数经过广泛多利益相关方磋商的 AI 治理文本。
框架的定位非常明确:自愿性、非认证性、技术中立、面向全生命周期。它既不是法规也不是标准,而是一套"结果导向"的风险管理方法——框架只规定组织应当达成什么样的风险管理结果(outcomes),不规定具体用什么技术、什么指标、什么阈值去实现,组织可以依据自身规模、行业和风险偏好裁剪使用。这一设计哲学与美国整体的"轻监管、重标准"AI 治理路线一脉相承,也使 AI RMF 与 2014 年发布的 NIST 网络安全框架(CSF)在结构上高度神似——后者的 Identify-Protect-Detect-Respond-Recover 五大功能,与 AI RMF 的四大功能形成清晰的家族对应。
2.2 七大"可信 AI"特征
AI RMF 的目标不是消除风险,而是帮助组织在设计、开发、部署和使用 AI 的全过程中管理风险、最大化正面影响。为此,框架定义了可信 AI 系统应当具备的七大特征,这七个特征构成了后续 MEASURE 功能的度量对象:
| 特征 | 内涵要点 |
|---|---|
| 有效且可靠(Valid & Reliable) | 系统在预期条件下准确、稳健地完成既定任务,鲁棒性被归入此特征 |
| 安全(Safe) | 在任何情况下不危害人类生命、健康、财产或环境 |
| 可安保且有韧性(Secure & Resilient) | 能抵御对抗性攻击并在受攻击后恢复 |
| 可问责且透明(Accountable & Transparent) | 系统行为可追溯到明确的责任主体,信息适当披露 |
| 可解释且可解读(Explainable & Interpretable) | 能说明输出背后的机制与依据 |
| 隐私增强(Privacy-Enhanced) | 保护个人数据的收集、使用与推断全过程 |
| 公平且有害偏见得到管理(Fair – with Harmful Bias Managed) | 识别并控制系统性偏见造成的伤害 |
这七大特征的意义在于,它们把"可信 AI"这个抽象口号拆解成了可以逐一测试和度量的工程属性。框架同时坦承这些特征之间存在内在张力——例如更高的可解释性可能牺牲准确性,更强的隐私保护可能降低公平性度量的可行性——因此组织必须结合具体应用场景做权衡,而不是追求所有特征的满分。这种"承认权衡"的务实态度,是 NIST AI RMF 区别于许多纯原则性宣言的重要特征。
2.3 核心结构:四大功能、19 个类别、72 个子类别
AI RMF 的核心(Core)是一个三层递进的结构:4 个功能(Functions)→ 19 个类别(Categories)→ 72 个子类别(Subcategories)。四大功能分别是 GOVERN、MAP、MEASURE、MANAGE,各功能下的类别与子类别分布如下:
| 功能 | 定位 | 类别数 | 子类别数 | 关键类别 |
|---|---|---|---|---|
| GOVERN(治理) | 横向贯穿:培育风险管理文化,建立政策、问责结构与流程 | 6(GOVERN 1–6) | 19 | 政策与流程、问责结构、人才多样性、组织文化、利益相关方参与、第三方风险 |
| MAP(映射) | 确立语境:识别系统边界、利益相关方与潜在影响 | 5(MAP 1–5) | 18 | 语境确立、系统分类、能力与成本收益、组件与第三方风险、对个人/群体/社会的影响 |
| MEASURE(测量) | 分析与跟踪:用定量、定性方法评估、基准化和监测风险 | 4(MEASURE 1–4) | 22 | 度量方法选择、可信特征评估(单类别含 13 个子类别,为全框架最大)、风险跟踪、反馈收集 |
| MANAGE(管理) | 处置与闭环:按优先级分配资源、响应事件、沟通与恢复 | 4(MANAGE 1–4) | 13 | 风险优先级排序、风险处置、第三方事件沟通、事件响应与恢复机制 |
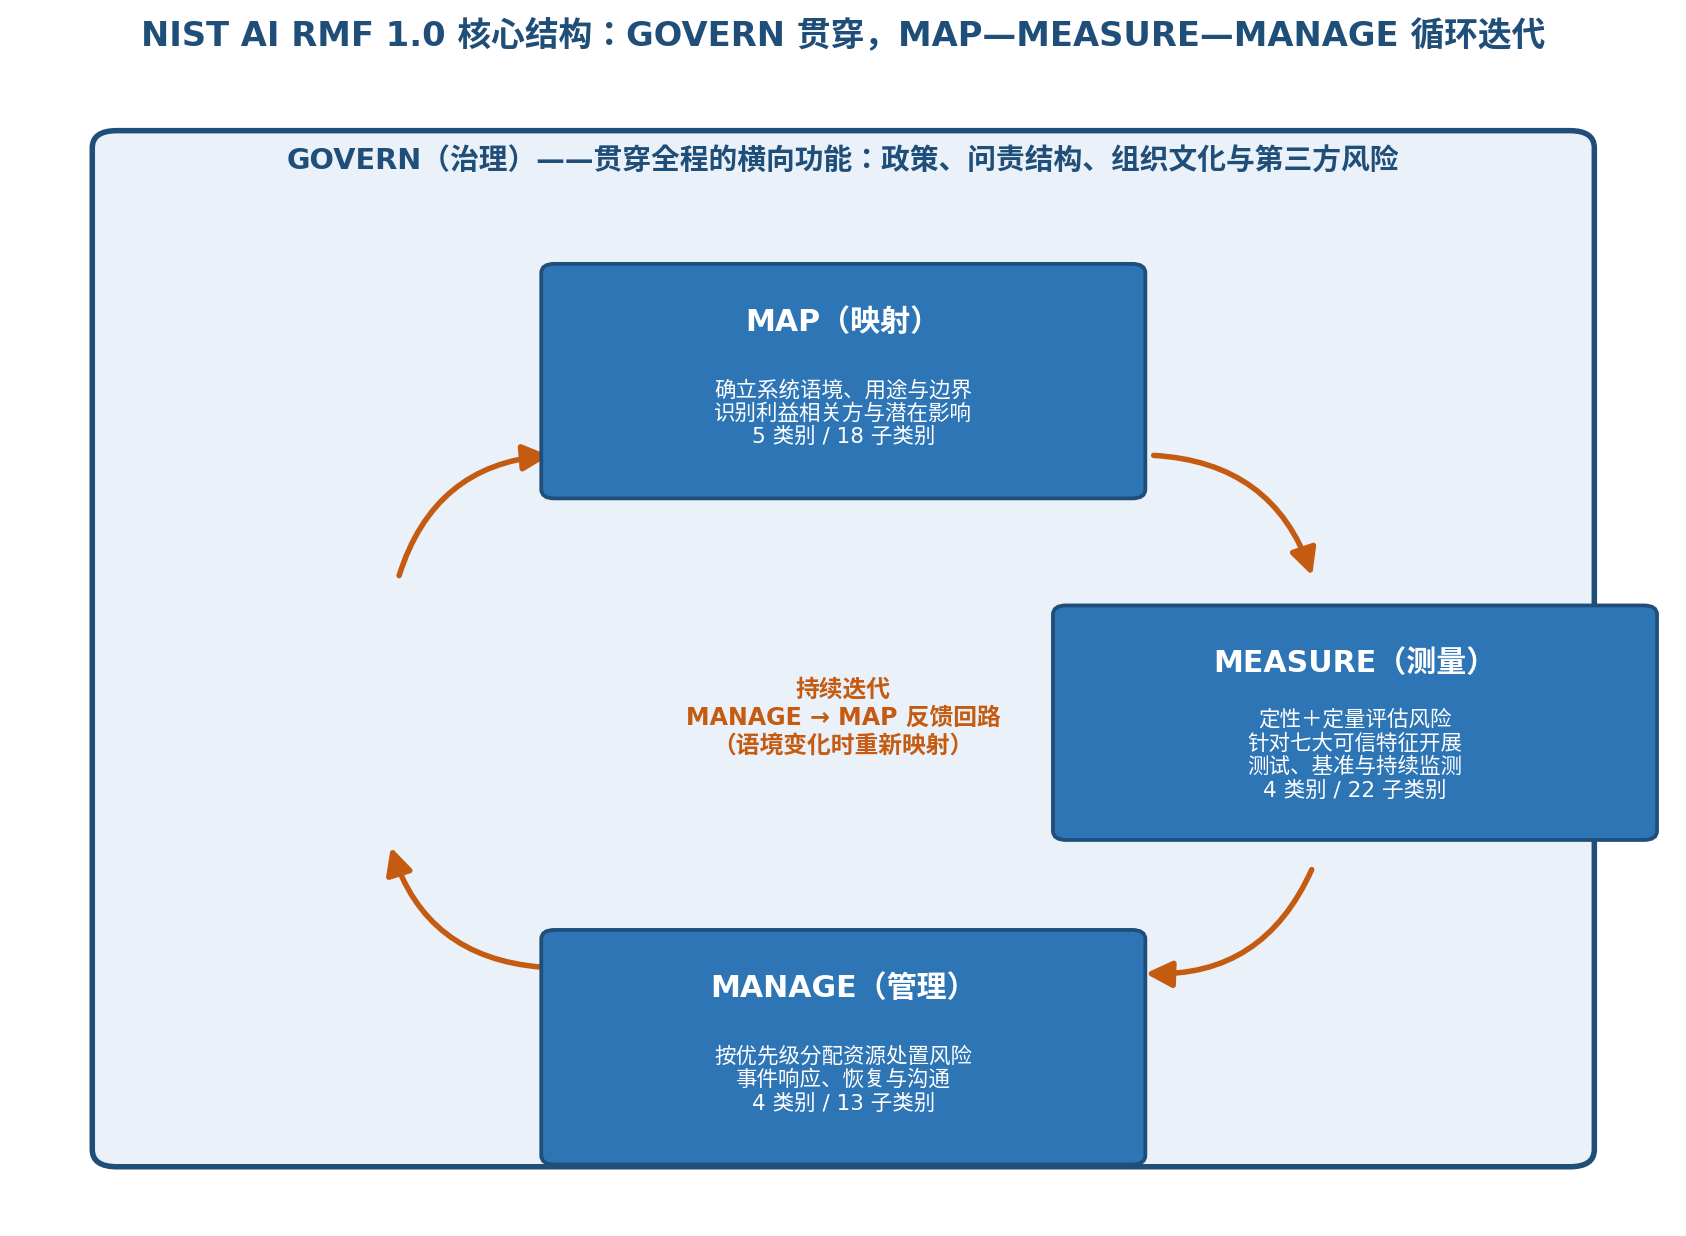
关于四大功能,有三个常见的误读需要澄清。第一,GOVERN 不是"第一步"而是"空气"——它是唯一被 NIST 明确定义为横向贯穿(cross-cutting)的功能,应当渗透在 MAP、MEASURE、MANAGE 的每一项活动中,而不是在项目启动时做一遍就束之高阁;治理政策应当在每次映射新系统、处置新风险时被重新审视。第二,四大功能不是线性流程而是迭代循环——框架在 1.0 版中特意加入了 MANAGE→MAP 的反馈回路:当系统语境发生变化(新用例、新数据源、新法规),组织必须回到 MAP 重新映射;否则系统进入 GOVERN 功能下的持续监测。第三,72 个子类别不是全做清单——NIST 明确允许组织按用例和风险容忍度选择相关子类别,但要求对暂缓实施的部分记录理由、补偿性控制和时间表。
四大功能各自回答一个实务问题:GOVERN 回答"出了事谁负责、谁能叫停",MAP 回答"风险藏在这个系统的哪个角落",MEASURE 回答"怎么在用户之前发现系统在劣化",MANAGE 回答"问题发生的那一刻怎么办"。以一个部署客服大模型的企业为例:GOVERN 层面需要指定对模型输出负最终责任的高管、设定风险容忍度并建立上报路径;MAP 层面需要梳理该模型的训练数据来源、面向的客户群体、可能出错的高危场景(如退款承诺、医疗建议);MEASURE 层面需要对幻觉率、偏见表现、提示注入抵抗能力做部署前测试和上线后持续监测;MANAGE 层面则需要准备输出事故的回滚方案、供应商(基础模型 API 方)行为变更时的应急流程,以及面向监管和客户的沟通预案。
2.4 Profiles、Playbook 与配套资源
围绕核心框架,NIST 提供了一整套配套资源帮助组织把框架从纸面落到地面。AI RMF Playbook 是在线伴侣文档,为每个子类别提供可执行的建议动作、参考文档和示例产出,它不是规范性的——组织像点菜一样选取适用动作。**Profiles(画像)**则是组织将核心框架适配到具体场景的载体:用例画像针对特定应用(如招聘、信贷),组织画像记录某个实体的风险偏好与控制选择,画像的价值在于让取舍显性化——例如对高影响系统要求更严格的测试,对低风险内部工具适用轻量评审。
此外,NIST 还发布了路线图(Roadmap)、跨框架映射(Crosswalks)和各行业视角文件。跨框架映射尤其实务:新加坡 IMDA 与 NIST 之间完成的治理框架互映射就是典型案例,它让跨国企业可以"一次建设、多处复用"治理证据,显著降低合规摩擦。学界和产业界也在此基础上延伸——例如有研究者基于 AI RMF 构建了成熟度模型问卷,将 72 个子类别转化为可打分的具体行为陈述,用于组织自评;金融服务领域则出现了将 AI RMF 翻译为行业控制目标的《金融服务 AI 风险管理框架》(FS AI RMF)。
2.5 生成式 AI Profile(NIST AI 600-1)
2022 年底生成式 AI 爆发后,基础框架的通用性很快显得不够用。2023 年 10 月,美国总统拜登签署第 14110 号行政令,要求 NIST 制定生成式 AI 专项指引;作为响应,NIST 于 2024 年 7 月 26 日发布《AI 风险管理框架:生成式人工智能画像》(NIST AI 600-1)。这份文件以 Profile 的形式将 GOVERN/MAP/MEASURE/MANAGE 四大功能映射到 12 类生成式 AI 特有或被显著放大的风险,并为每类风险提供 200 多项建议动作,按开发者、部署者、最终用户等不同角色标注适用对象:
| # | 风险类别 | 典型内容 |
|---|---|---|
| 1 | CBRN 信息或能力 | 降低获取化学、生物、放射、核威胁信息的门槛 |
| 2 | 幻觉(Confabulation) | 以与真实信息相同的语言置信度输出虚假内容 |
| 3 | 危险、暴力或仇恨内容 | 煽动、自残指引、仇恨言论的规模化生成 |
| 4 | 数据隐私 | 训练数据记忆复现、成员推断、去匿名化 |
| 5 | 环境影响 | 训练与推理的能耗与碳足迹(文件援引估算:训练一个 Transformer 大模型的碳排放约等于 300 个旧金山—纽约往返航班) |
| 6 | 有害偏见与同质化 | 偏见输出以及内容生态多样性的长期收窄 |
| 7 | 人机配置 | 过度依赖、自动化偏差、拟人化误导 |
| 8 | 信息完整性 | 合成媒体、深度伪造、错误/虚假信息传播 |
| 9 | 信息安全 | 提示注入、模型窃取、数据外泄等新攻击面 |
| 10 | 知识产权 | 训练数据来源、输出版权与侵权风险 |
| 11 | 淫秽、贬损或虐待内容 | 包括非自愿私密影像(NCII)与 CSAM |
| 12 | 价值链与组件集成 | 第三方模型、数据集、插件的不可追溯集成 |
AI 600-1 的操作性明显强于基础框架:它不只说"管理偏见风险",而是给出具体动作,例如把幻觉当作校准问题而非单纯准确率问题来度量、对 CBRN 类查询做专项红队测试、建立内容溯源(数字水印、元数据追踪、数字指纹)机制、设立"停止构建权"(stop-build authority)等。值得注意的是它的时效性安排:该文件虽依据已被撤销的 EO 14110 制定,但作为自愿性指南仍然有效并被广泛引用。同时其局限也已显现——12 类风险主要围绕"模型会生成什么有害内容"组织,而 2025 年后兴起的智能体(Agentic AI)的核心风险是"模型会执行什么有害动作",学界和云安全联盟(CSA)已开始研制面向智能体的 Profile 以弥补这一缺口。
2.6 2025–2026 年政策转向下的 NIST AI 治理体系
NIST AI RMF 所处的美国政策环境在 2025 年发生了根本性转向。2025 年 1 月 20 日,特朗普政府撤销了拜登的 EO 14110;1 月 23 日签署 EO 14179《消除美国人工智能领导力障碍》,要求各机构全面审查并废止与"创新优先"路线不一致的既有 AI 政策。2025 年 6 月,商务部长宣布将 NIST 下属的 AI 安全研究所(AISI)更名为 AI 标准与创新中心(CAISI),使命表述从"安全"转向"标准";2026 年 5 月,其配套的 AISI 联盟也更名为 NIST 人工智能联盟,研究议程从系统性风险缓释扩展到 AI 测量、创新与美国 AI 技术的全球推广。
对 AI RMF 本身而言,最重要的信号来自 2025 年 7 月 23 日发布的《美国 AI 行动计划》(America's AI Action Plan):它明确指示 NIST 修订 AI RMF,删除其中关于错误信息(misinformation)、多元公平包容(DEI)和气候变化的表述。这意味着这个经多利益相关方磋商形成、被全球广泛采用的框架,其内容将首次受到明确的政治性修订,其作为"中立技术基线"的国际信誉面临考验。与此同时,NIST/CAISI 的技术产出并未停滞:2025 年 12 月发布《网络 AI Profile》初步草案(IR 8596),2026 年 2 月启动 AI 智能体标准倡议(AI Agent Standards Initiative),2026 年 3 月发布关于部署后监测的 NIST AI 800-4,2026 年 4 月提出关键基础设施 AI RMF Profile 概念文件。2026 年 6 月,EO 14409 进一步建立了由 CAISI 主导的前沿模型发布前"自愿性"审查机制。总体来看,NIST AI RMF 的工具地位依然稳固,但其内容演化值得持续跟踪。
3. 与 NIST AI RMF 并列的主要框架
3.1 ISO/IEC 42001:可认证的 AI 管理体系标准
如果说 NIST AI RMF 教你"如何思考 AI 风险",ISO/IEC 42001:2023 则提供了"让别人证明你做到了"的机制。该标准于 2023 年 12 月发布,全称《信息技术—人工智能—管理体系》,是全球首个 AI 管理体系(AIMS)标准,也是目前主流 AI 治理框架中唯一可被第三方认证的一个。它与 ISO 27001(信息安全)、ISO 9001(质量管理)共享同一套协调结构(Harmonized Structure),可认证要求分布在第 4 至第 10 章,遵循 PDCA(计划—执行—检查—改进)循环:
| 章节 | 主题 | 核心要求 |
|---|---|---|
| 第 4 章 | 组织环境 | 界定 AIMS 范围、识别利益相关方 |
| 第 5 章 | 领导力 | 最高管理层对 AI 政策负责、分配角色与资源 |
| 第 6 章 | 策划 | AI 风险评估与处置、AI 目标、AI 系统影响评估流程(6.1.4) |
| 第 7 章 | 支持 | 资源、能力、意识、沟通、文件化信息 |
| 第 8 章 | 运行 | 执行风险处置、定期开展影响评估(8.4)、管理 AI 生命周期 |
| 第 9 章 | 绩效评价 | 监视测量、内部审核、管理评审 |
| 第 10 章 | 改进 | 不符合项纠正与持续改进 |
区别于信息安全标准的关键要求是 AI 系统影响评估:组织必须评估 AI 系统对个人、群体和社会(而不仅是对组织自身)的影响,并在系统发生重大变化时重新评估、留存结果——公平性、安全与人权考量由此被制度化。标准还附有约 38 项 Annex A 控制措施、横跨 9 个控制域(政策、内部组织、资源、影响评估、数据、信息披露等),组织需编制《适用性声明》(SoA)说明每项控制的取舍理由。认证流程与 ISO 27001 类似:一阶段文件审核+二阶段运行审核,证书三年有效、每年监督审核;配套标准 ISO/IEC 42006:2025 则规范了认证机构本身的资质。
需要厘清三个常见误解:其一,认证对象是组织的管理体系而非某个 AI 模型——正如 ISO 9001 不保证每件产品无瑕疵;其二,它适用于 AI 的使用者而不仅是开发者,一家采购第三方信贷模型的银行同样可以认证;其三,获得 ISO 42001 认证不等于符合欧盟 AI 法——截至 2026 年它尚非欧盟官刊引用的协调标准,不产生"合规推定",欧洲另在制定 prEN 18286 以满足 AI 法第 17 条的质量管理体系要求,但一个运行良好的 AIMS 确实能为 AI 法合规提供大部分组织基础设施。与 NIST AI RMF 的关系则是互补而非竞争:RMF 的风险管理工作可以直接作为 42001 审核的输入证据。
3.2 欧盟《人工智能法》:全球首部综合性 AI 立法
欧盟《人工智能法》(Regulation (EU) 2024/1689)于 2024 年 8 月 1 日生效,是全球第一部横向、综合性的 AI 立法,采用基于风险的分级监管模式,将 AI 系统分为四档:
| 风险等级 | 典型场景 | 法律后果 |
|---|---|---|
| 不可接受风险 | 社会评分、操纵脆弱人群、基于敏感特征的生物识别分类、特定实时远程生物识别 | 禁止(2025 年 2 月 2 日起执行) |
| 高风险 | 医疗、招聘筛选、信贷评分、教育、关键基础设施、执法、生物识别 | 合格评定、技术文档、数据治理、人类监督、准确性/鲁棒性/网络安全、日志、上市后监测、CE 标志 |
| 有限风险 | 聊天机器人、推荐系统、生成式工具 | 透明度义务(披露 AI 交互、标识 AI 生成内容) |
| 极小风险 | 垃圾邮件过滤、游戏 AI 等绝大多数应用 | 基本无义务,鼓励自愿行为准则 |
其实施采取分阶段推进:2025 年 2 月 2 日禁令与 AI 素养义务生效;2025 年 8 月 2 日通用目的人工智能(GPAI)模型义务与治理架构(含欧盟 AI 办公室)开始适用;原定于 2026 年 8 月 2 日全面适用的附件 III 高风险义务,经 2026 年"数字总括法案"(Digital Omnibus)调整延后至 2027 年 12 月 2 日,附件 I 嵌入式产品义务延至 2028 年 8 月——但透明度义务(第 50 条)仍按原计划于 2026 年 8 月 2 日适用。罚则采用三档结构:违反禁令最高 3500 万欧元或全球年营业额 7%(高于 GDPR 的 4%),违反高风险等义务最高 1500 万欧元或 3%,提供误导信息最高 750 万欧元或 1%。
GPAI 规则是欧盟模式最具外溢性的创新:训练算力达到 10²⁵ FLOPs 的模型被推定具有"系统性风险",需承担模型评估、对抗测试、事件报告等额外义务,目前全球仅约 5–15 家公司触及该门槛。欧盟委员会 2025 年 7 月发布《GPAI 行为准则》,26 家机构(含 OpenAI、Google、Microsoft、Anthropic、Mistral 等)签署以获得"合规推定",而 Meta 公开拒绝签署。落地进度方面则不容乐观:截至 2026 年 4 月,78% 的组织尚未采取实质性的合规准备,超过一半连基本的 AI 清单都没有;至少 12 个成员国错过了主管机构指定的法定期限。与 NIST AI RMF 的本质区别在于:AI RMF 是自愿的过程方法论,欧盟 AI 法是强制的市场准入法规——前者告诉你怎么管理风险,后者规定不满足条件就不能在欧洲卖。
3.3 OECD《AI 原则》与 UNESCO《AI 伦理建议书》
OECD《AI 原则》是首个政府间 AI 标准,2019 年 5 月通过、2024 年 5 月修订以应对通用与生成式 AI,目前共 47 个国家和地区加入。它包含五条价值导向原则——包容性增长与可持续发展、人权与民主价值(含公平与隐私)、透明与可解释、鲁棒安全与安保、问责——以及五条面向政策制定者的建议(投资研发、培育生态、塑造可互操作的治理环境、人力建设与劳动力转型、国际合作)。2024 年修订特别扩展了对 AI 放大的错误/虚假信息、隐私、知识产权和安全问题的表述。这些原则无强制力,但构成了后续多数立法的规范性底座——欧盟 AI 法的风险导向与人权框架即深受其影响。
UNESCO《人工智能伦理问题建议书》则于 2021 年 11 月由 193 个会员国一致通过,是首个全球性的 AI 伦理规范框架,确立四大价值(人权与尊严、和平公正社会、多样性与包容、环境繁荣)与十项原则(含相称性、安全、公平、透明、人类监督),并配套覆盖性别、数据、国际合作等 11 个政策行动领域的具体建议。与 OECD 原则相比,UNESCO 文本更强调文化多样性、环境可持续与发展中国家需求,体现了真正的全球性磋商成果。这两份文件构成了 AI 治理的"价值原则层":它们不直接约束企业,但为各国立法提供了共同词汇,也是跨国企业在无硬法辖区构建内部政策时的默认参照。
3.4 欧洲委员会《AI 框架公约》(CETS 225)
《欧洲委员会人工智能与人权、民主和法治框架公约》(CETS No. 225)于 2024 年 5 月 17 日通过、2024 年 9 月 5 日在维尔纽斯开放签署,是首部具法律约束力的国际 AI 条约。首批签署方包括欧盟、英国、美国、以色列及多个欧洲委员会成员国,加拿大和日本于 2025 年 2 月加入。公约采取原则性路径:要求缔约方确保 AI 全生命周期活动符合人权、民主与法治,涵盖透明与监督、风险与影响管理、禁止与人权不相容的用途、独立监督机构等义务群。
理解该公约必须把握两点。第一,"有约束力"约束的是国家而非企业:条约不创设可直接起诉或罚款公司的义务,缔约方需通过国内法转化实施,且不具自动执行力——这导致同一公约在欧盟(借 AI 法实施)、英国(轻量共同监管)和美国(参议院未批准,实际无法执行义务)呈现出天差地别的落地形态。第二,截至 2026 年 8 月公约尚未生效:生效需 5 个批准(含至少 3 个欧洲委员会成员国),而截至 2026 年 6 月初仅欧盟一家于 2026 年 5 月 15 日交存批准书,且欧盟作为国际组织不计入成员国门槛。它的历史意义在于确立了 AI 治理的国际人权基线,但短期内的实际约束仍须回到各辖区国内法。
3.5 G7 广岛进程与其他多边机制
G7"广岛 AI 进程"于 2023 年 10 月产出《先进 AI 系统开发组织国际行为准则》与指导原则,2025 年初进一步推出"报告框架"(Reporting Framework),用于监测企业对行为准则的自愿遵守情况、提升透明度。联合国层面,2024 年 3 月大会通过首个 AI 决议(A/RES/78/265),2024 年 9 月通过《全球数字契约》。峰会序列也在持续演化:2023 年 11 月布莱奇利峰会(29 国签署首份全球 AI 安全宣言,中美首次同场)、2024 年 5 月首尔峰会(16 家企业签署前沿 AI 安全承诺)、2025 年 2 月巴黎行动峰会(美英拒签宣言,首次显现地缘裂痕)、2026 年 2 月新德里峰会(92 国签署,但以明确拒绝"全球治理"概念为代价换取最广共识)。这些机制的共同特征是"软法"属性:维系共同词汇、促进信息共享,但无一能改变企业在具体辖区的法定义务。
4. 主要国家与地区的治理路径
4.1 美国:联邦真空下的"州法拼图+自愿框架"
美国联邦层面在 EO 14110 被撤销后已无综合性的横向 AI 监管对应物,治理重心转向"创新优先+采购杠杆+州法拼图"。NIST AI RMF 及其配套文件构成技术基线;OMB 备忘录约束联邦机构自身的 AI 采购与使用;FTC 则沿用以《联邦贸易委员会法》第 5 条为核心的行为执法路径,2025 年 12 月撤销 Rytr 同意令、2026 年 3 月发布 AI 与第 5 条政策声明,表明联邦执法正围绕"行为责任"而非"产品安全义务"整合。与此同时,2025 年 12 月的行政令设立了司法部 AI 诉讼特别工作组,推动联邦对州 AI 立法的优先权(preemption)策略,为合规增添了不确定性。
州层面形成了三种有代表性的模式。科罗拉多州 SB 24-205(《人工智能法》)是美国唯一基于风险的综合性州法,其最精巧的设计是积极抗辩机制:部署者若实施并维护了符合 NIST AI RMF 或 ISO/IEC 42001 等国家/国际风险管理框架的政策与程序,可在总检察长的执法行动中主张抗辩;通过反馈、红队测试或内部审查发现并纠正违规的,同样可获抗辩——这使 NIST AI RMF 从"自愿指南"变成了诉讼中的"护身符"。该法由州总检察长专属执法,不设私人诉权。得克萨斯州 TRAIGA 采取基于主观意图的禁止性清单模式;加利福尼亚州则以 SB 53(前沿模型透明与安全)、AB 2013(训练数据透明)、SB 942(AI 透明度)、SB 243(陪伴型聊天机器人)等多部专项法叠加成网。对企业而言,美国合规的难点正在于这种联邦缺位下的碎片化——一套以 NIST AI RMF 为骨架的治理体系是目前跨州复用性最强的选择。
4.2 中国:以应用服务为切入点的"敏捷治理"
中国未直接针对"模型"立法,而是以应用服务为切入点,通过算法治理逐步实现对模型层的延伸规制,形成了层次分明、迭代迅速的监管体系:
| 时间 | 文件 | 核心抓手 |
|---|---|---|
| 2021 | 《互联网信息服务算法推荐管理规定》 | 算法备案、算法机制审核、安全评估 |
| 2022 | 《互联网信息服务深度合成管理规定》 | 深度合成(含深度伪造)标识与备案 |
| 2023.8 | 《生成式人工智能服务管理暂行办法》 | 训练数据治理、内容安全、具有舆论属性或社会动员能力的服务须安全评估并履行算法备案 |
| 2023.10 | 《全球人工智能治理倡议》 | 对外提出"以人为本、智能向善"的治理主张 |
| 2024.9 | 《人工智能安全治理框架》1.0(TC260) | 风险分类与综合治理措施框架 |
| 2025.9.1 | 《人工智能生成合成内容标识办法》生效 | AI 生成内容的显式/隐式标识,建立"生成—传播—使用"全链条可追溯 |
| 2025.9.15 | 《人工智能安全治理框架》2.0 | 三类风险(技术内生、应用安全、应用衍生)+五级风险分级+动态治理措施 |
执行层面,算法备案制构成最具中国特色的抓手:截至 2025 年 6 月,已有 433 款大模型完成备案并上线提供服务。标准化工作同步推进,全国网络安全标准化技术委员会(TC260)已发布 GB/T 45652-2025(生成式 AI 预训练和优化训练数据安全规范)、GB/T 45654-2025(生成式 AI 服务安全基本要求)、GB/T 45674-2025(数据标注安全规范)等国家标准,并围绕金融、医疗、教育、政务等行业研制安全指引。与欧盟的横向风险分级立法不同,中国模式被概括为"包容审慎、敏捷治理":《人工智能安全治理框架》2.0 提出五大原则(包容审慎保安全、敏捷识别风险、技管结合协同响应、开放合作共治共享、可信应用防失控),并首次将灾难性风险纳入应用衍生风险考量。对在华运营的企业而言,备案、标识与内容安全是三条不可回避的合规主线。
4.3 英国:不立法、靠监管机构的"促进创新"路线
英国刻意选择了与欧盟相反的路径。2023 年 3 月,科学、创新与技术部(DSIT)发布白皮书《促进创新的 AI 监管方法》,确立五项跨部门原则——安全、安保与鲁棒性;适当的透明与可解释;公平;问责与治理;可争议性与救济——但不设统一的 AI 监管机构、不搞横向立法,而是由 FCA、ICO、CMA、Ofcom、MHRA 等既有行业监管机构在各自法定权限内解释和落实这些原则。政府 2024 年 2 月的回应文件确认近期不会推出跨部门 AI 法;截至 2026 年年中,2026 年议会会期的国王演讲中仍无 AI 法案。
机构层面,英国 2023 年 11 月成立了全球首个 AI 安全研究所(AISI),2025 年 2 月更名为 AI 安保研究所(AI Security Institute),聚焦前沿模型的灾难性风险与国家安全风险评估,但不行使市场监管职权。这条"轻立法、重能力"路线的优点是灵活、对创新友好;代价则是监管确定性弱——企业面对的是若干行业监管机构各自的指引,而非一部统一的法典。实践中,在英经营的跨国企业通常仍以 NIST AI RMF/ISO 42001 为内部骨架,再逐部门对接各行业监管机构的期望。
4.4 韩国与日本:亚太的两种立法范式
韩国《人工智能基本法》(全称《人工智能发展与信任基础创建基本法》)于 2024 年 12 月通过、2025 年 1 月 21 日签署,2026 年 1 月 22 日正式生效——成为继欧盟之后全球第二部综合性 AI 立法,且具有域外效力:凡对韩国市场产生实质影响的 AI 系统均在管辖范围内,外国运营商须指定韩国境内代表。法案以"高影响 AI"(医疗、金融、就业、公共基础设施等领域)为监管重心,要求建立风险管理体系、人类监督机制、基本权利影响评估,并对高影响或生成式 AI 的使用履行用户告知义务、对 AI 生成内容明确标识;罚则包括最高 3000 万韩元罚款及严重情形下的刑事责任。配套立法推进中曾出现延迟——施行令草案直到 2025 年 9 月 8 日才发布(原定 6 月),包含 34 条规定;2025 年 9 月成立的国家 AI 战略委员会则在 2026 年 2 月敲定了含 99 项行动任务的 AI 行动计划。
日本《人工智能促进法》(全称《人工智能相关技术研发与利用促进法》)于 2025 年 5 月 28 日通过,多数条款 2025 年 6 月 4 日生效,AI 战略本部与 AI 基本计划章节于 9 月 1 日生效——代表了**"促进型立法"**范式:不设罚款、不设直接处罚,而是确立国家目标、设立首相挂帅的 AI 战略本部、制定 AI 基本计划,靠指导、建议、信息公开与"公开点名"推动企业自律。实质性约束依赖既有部门法(个人信息保护法 APPI、竞争法、知识产权法、产品安全法)以及 METI/MIC 联合发布的《AI 治理指南》(2025 年 3 月 v1.1),后者要求企业开展风险评估、记录安全/公平/偏见测试、确保透明可解释、建立监测与事件处理机制,并以"遵守或解释"方式运作。韩日两国恰好构成亚太立法的两极:一个走向欧盟式综合立法,一个坚持创新优先的软法路径。
4.5 新加坡:自愿框架做到世界最前沿
新加坡没有、也不打算推出统一的 AI 法,但其**《AI 治理示范框架》(Model AI Governance Framework)已成为全球自愿框架的标杆,并保持着罕见的迭代速度:2019 年首版(2020 年第二版)面向传统 AI;2024 年 5 月发布生成式 AI 版**,围绕问责、数据、可信开发与部署、事件报告、测试与保障、安全、内容溯源、安全与对齐研究、AI 公益九大维度组织,并强调模型创建者、应用开发者、部署者之间的"责任共担";2026 年 1 月 22 日在世界经济论坛上发布全球首个智能体 AI 治理框架(Model AI Governance Framework for Agentic AI),围绕风险界定与约束、有意义的人类问责、技术控制、终端用户责任四个维度,解决自主规划与行动型 AI 的治理难题。
新加坡模式的另一特色是"框架+工具"的组合:AI Verify 是开源的 AI 治理测试框架与工具包,组织可据以对齐国际治理原则运行技术测试与流程检查并生成报告,由 IMDA 旗下的 AI Verify 基金会运营。虽然框架本身自愿,但新加坡金融管理局(MAS)的《技术风险管理指引》对持牌金融机构具有约束力,并将框架原则纳入 AI/ML 风险控制要求——自愿框架经由"监管桥梁"事实上强制化。此外,IMDA 与 NIST 完成了治理框架互映射,为跨国企业提供了跨辖区复用治理证据的通道。新加坡证明了自愿框架也能产生全球影响力——前提是它足够具体、足够可操作,并且持续跟踪技术前沿。
5. 主要框架横向对比
综合前文,下表对七大主流框架做集中对比(同一实体的关键属性聚合呈现,便于选型参考):
| 维度 | NIST AI RMF 1.0+AI 600-1 | ISO/IEC 42001:2023 | 欧盟《AI 法》 | OECD《AI 原则》 | 韩国《AI 基本法》 | 新加坡 MGF 系列 | 中国监管体系 |
|---|---|---|---|---|---|---|---|
| 发布方/时间 | 美国 NIST,2023.1/2024.7 | ISO/IEC,2023.12 | 欧盟,2024.8 生效 | OECD,2019/2024 修订 | 韩国国会,2026.1 生效 | IMDA,2019–2026 三代 | 网信办等+TC260,2021 起持续迭代 |
| 性质 | 自愿框架 | 可认证管理体系标准 | 强制性法规 | 政府间原则 | 强制性法规 | 自愿框架(金融业经 MAS 强制化) | 强制性法规+自愿框架+国家标准 |
| 核心结构 | 4 功能/19 类别/72 子类别+12 类 GenAI 风险 | 第 4–10 章 PDCA+38 项 Annex A 控制 | 四档风险分级+GPAI 专章 | 5 原则+5 建议 | 高影响 AI 义务群+透明标识 | 9 大治理维度(GenAI 版) | 备案+标识+安全评估+三类五级风险分级 |
| 可否认证 | 否(自我评估) | 是(第三方认证,3 年周期) | 合格评定+CE 标志 | 否 | 否(法定检查) | 否(AI Verify 提供测试报告) | 备案制 |
| 罚则 | 无 | 无 | 最高全球营业额 7% | 无 | 最高 3000 万韩元+刑责 | 无(金融业除外) | 依上位法处罚 |
| 域外效力 | 不适用 | 全球通用 | 是(布鲁塞尔效应) | 47 国加入 | 是 | 区域影响力强 | 境内服务为主 |
| 最适合的角色 | 内部风险治理骨架 | 对外证明治理能力 | 欧洲市场准入门槛 | 政策对话与内部价值观 | 韩国市场合规 | 东南亚业务与前沿技术治理 | 在华服务合规 |
从这张表可以提炼出三条结构性结论。第一,方法论、认证、法规三者各司其职:NIST AI RMF 提供最细的过程方法论但无法自证,ISO 42001 提供第三方背书但不替代法律,欧盟 AI 法等法规划定市场门槛但不教你怎么做——跨国企业的最优解是以 RMF/42001 建一套治理体系,再用映射表满足各辖区法规。第二,强制性框架正在沿"欧盟→韩国→(潜在的)其他辖区"扩散,而自愿框架沿"NIST→新加坡→英国"路径深化,两条路径在"基于风险、强调人类监督、要求透明标识"等核心要素上高度趋同。第三,域外效力成为常态:欧盟 AI 法、韩国 AI 基本法均具有域外管辖设计,意味着企业即使总部不在这些辖区,只要服务触及当地市场就需要对应合规。
6. 企业落地:采纳现状、实施路径与常见失败模式
6.1 采纳现状:一条巨大的"治理落差带"
多项 2025–2026 年行业调查勾勒出同一幅图景:AI 采纳速度远远跑赢治理能力。麦肯锡 2025 年 11 月的调研显示 88% 的组织已在至少一个业务职能中使用 AI,但近三分之二仍停留在试验或试点阶段;而 Economist Impact 的研究发现,全球仅 8% 的组织拥有全面的 AI 治理框架,小型企业这一比例低至 2%。世界经济论坛与埃森哲 2025 年 9 月的报告更为严峻:不足 1% 的组织已将负责任 AI 完全运营化,81% 仍停留在成熟度的最初阶段。
落差体现在治理的每个环节:75% 的组织有 AI 使用政策,但仅 59% 设有专职治理角色、54% 有 AI 事件响应手册、48% 对生产环境 AI 系统做持续监测(小企业低至 9%);仅 30% 的组织将生成式 AI 系统真正部署到生产。智能体治理是缺口之最:德勤发现 74% 的组织计划两年内采用智能体 AI,但仅 21% 具备成熟的智能体治理模型;另有 35% 的组织承认如果 AI 智能体失控,自己无法将其关停。风险后果已在数据上显现:斯坦福 HAI 的 2026 年 AI 指数记录 2025 年 AI 相关事件 362 起,较 2024 年的 233 起上升 55%;IBM 数据则显示 13% 的组织遭遇过 AI 模型或应用相关的泄露,其中 97% 缺乏恰当的 AI 访问控制。
好消息是治理投入的回报同样可度量:Gartner 对 360 家组织的调查发现,部署了 AI 治理平台的组织实现高治理有效性的概率是未部署者的 3.4 倍;CSA 与 Google Cloud 的联合调查显示,拥有全面治理政策的组织早期采用智能体 AI 的比例(46%)接近政策不健全组织(25%/12%)的两倍到四倍,且 65% 已对员工开展 AI 培训(对比 27%/14%);Writer 的研究则发现有正式 AI 战略的组织采纳成功率达 80%,无战略者仅 37%。治理不是创新的刹车,而是规模化的前提——这一判断已获得相当一致的数据支持。
6.2 框架选型建议
不同类型的组织,合理的框架组合并不相同:
| 组织类型 | 建议组合 | 理由 |
|---|---|---|
| 跨国经营的大中型企业 | NIST AI RMF(骨架)+ISO/IEC 42001(对外认证)+各辖区法规映射(欧盟 AI 法、韩国 AI 基本法、中国备案/标识) | 一次建设、多处复用;42001 证书应对采购问卷,RMF 证据支撑美国州法抗辩 |
| 面向美国市场的企业 | NIST AI RMF 优先,叠加科罗拉多/得州/加州等州法核查 | RMF 是州法积极抗辩与联邦采购的共同基线 |
| 面向欧盟市场的企业 | 欧盟 AI 法合规为主线,ISO 42001 提供管理体系基础设施 | AI 法为强制门槛;注意 42001 不产生合规推定 |
| 在华提供服务的企业 | 算法备案+生成合成内容标识+《人工智能安全治理框架》2.0 对齐 | 备案与标识为法定动作,框架 2.0 提供风险分类分级方法 |
| 金融机构 | 行业框架优先(如美国 FS AI RMF、MAS TRM 指引),RMF 为通用骨架 | 行业监管已把通用框架转译为行业控制目标 |
| 初创/中小企业 | 轻量起步:AI 清单+高风险用例的 MAP/MEASURE,不必追求全量 72 子类别 | 框架明确允许按风险裁剪,先解决可见性再谈体系化 |
无论选择哪种组合,有两条经验是普适的。其一,从清单(inventory)开始——没有对企业内 AI 工具、供应商 AI 功能、内部模型、员工自发使用(影子 AI)的完整可见性,任何治理都是空中楼阁;欧盟合规咨询机构的观察显示,超过一半的组织连基本的 AI 清单都未建立。其二,避免"多框架多套体系"——主流框架之间的重叠度很高(风险导向、人类监督、透明、持续监测),正确做法是建一套统一治理体系,再用 crosswalk 把同一份证据映射到不同框架要求上,而不是为每个框架各建一套流程。
6.3 实施路径:一个可操作的推进序列
综合 NIST 配套资源与行业实践,一个务实的落地序列大致如下。第一阶段(约 1 个月)建立可见性:盘点全部 AI 用例(自研模型、供应商 AI 功能、试点项目、员工自用工具),为每个用例记录业务目的、数据、责任人、供应商、客户影响。第二阶段建立治理骨架(GOVERN):指定对 AI 风险负最终责任的高管与委员会,书面化风险偏好与审批路径,明确"谁能叫停上线",将第三方模型纳入供应商风险管理。第三阶段对高优先级系统做 MAP+MEASURE:不必铺开到全部系统,先选 2–3 个高影响用例,完成语境映射、风险识别和部署前测试(幻觉率、偏见、提示注入抵抗等),并建立上线后的持续监测指标。第四阶段闭环 MANAGE:把未处置的风险转为有责任人、有期限、有证据要求的整改事项,准备事件响应与回滚预案,并将经验教训回流到 GOVERN 的政策修订。
对于生成式 AI 场景,应在此基础上叠加 AI 600-1 的 12 类风险核查:基础模型与数据集供应商的尽职调查记录、内容溯源机制(水印/元数据)、幻觉率的可接受阈值与 go/no-go 上线闸门、针对 CBRN 与越狱的专项红队、以及事故披露协议。整个体系运转起来之后,组织的成熟度标志不是"文档齐了",而是四个功能形成真正的循环:监测发现的漂移能触发重新映射,事件复盘能更新治理政策,新法规出台能快速定位受影响的用例。
6.4 常见失败模式
业界对 AI RMF 项目的复盘揭示了几种反复出现的失败模式。最典型的是**"有纸面无实践"**:企业采纳框架后写了治理政策(GOVERN)、做了 AI 清单和几份系统语境文档(MAP),然后悄悄跳过 MEASURE——因为缺乏持续基准化风险所需的数据基础设施——MANAGE 则退化为"出了事再说";结果是框架挂在内网上,运营现实毫无改变。PwC 2025 年的负责任 AI 调查从另一侧印证了这一点:50% 的高管认为"把负责任 AI 原则转化为可运营的流程"是最大障碍,高于文化阻力、预算、工具等所有其他选项。
第二类失败是把治理当一次性项目:AI 系统的风险画像随数据、用户、用例的变化而持续改变,把 MAP-MEASURE-MANAGE 做成上线前的一次性清单,必然导致监测盲区——近半组织不监测生产环境 AI 系统的现状说明这绝非个案。第三类失败是治理与业务脱节:44% 的受访 AI 负责人认为治理流程"太慢"、24% 认为"不堪重负",当治理成为纯粹的合规瓶颈时,业务团队会绕道而行,催生影子 AI——而高影子 AI 使用的组织平均多承担 67 万美元的泄露成本。破解之道是把治理嵌入工程工作流(上线闸门、自动化测试、运行时护栏),让"合规证据"成为系统运行的副产品而非额外的文书负担。
7. 前沿趋势:从生成式 AI 治理走向智能体治理
2025–2026 年,治理框架的演进前沿已从"内容生成"转向"自主行动"。智能体 AI 的风险性质发生了根本变化:传统生成式 AI 的风险是"说了什么有害的话",而智能体的风险是"做了什么有害的事"——一次成功的提示注入不再只是产生有害输出,而是可能执行不可逆的现实世界动作。主流框架已纷纷跟进:新加坡 2026 年 1 月发布全球首个智能体 AI 治理示范框架,提出行为边界、工具访问白名单、人类审批检查点等控制维度;NIST/CAISI 于 2026 年 2 月启动 AI 智能体标准倡议,并已在规划针对智能体的 AI RMF 控制叠加层;Gartner 则在 AI TRiSM 框架下提出"监护智能体"(Guardian Agents)概念——用以监督和执行其他 AI 智能体行为的运行时强制层,并预测到 2028 年 80% 的未授权 AI 智能体交易将源于内部策略违规而非外部攻击。
宏观层面,三个趋势值得持续关注。其一,"软法硬化"与"硬法调适"并行:一方面 ISO 42001 认证、NIST RMF 抗辩机制让自愿框架获得准强制地位;另一方面欧盟通过数字总括法案延后高风险义务、美国以联邦优先权威胁州法,显示出硬法也在向产业现实回调。其二,运行时执行取代周期性审查成为治理重心:AI TRiSM 的四层模型(信息治理、运行时检查与执行、AI 治理、基础设施栈)和"治理即代码"的实践,正在把治理从年度审计变成毫秒级的在线拦截。其三,国际协调在分歧中维持底线共识:新德里峰会以拒绝"全球治理"为代价换来 92 国共识,欧洲委员会公约仍在等待生效,但"基于风险、人类监督、透明标识"的核心要素已在所有主要框架中收敛。对组织而言,这意味着以 NIST AI RMF 这类方法论框架打底、持续跟踪各辖区法规演化的"以不变应万变"策略,在可预见的将来仍然成立。
8. 结语
NIST AI RMF 的价值,在于它第一次为"AI 风险"这个模糊的焦虑提供了一套可分解、可指派、可迭代的通用语言:GOVERN 解决"谁负责",MAP 解决"风险在哪",MEASURE 解决"如何知道",MANAGE 解决"出了事怎么办"。它并不孤单——ISO/IEC 42001 赋予治理以可认证性,欧盟 AI 法赋予其以强制性,OECD 与 UNESCO 原则赋予其以价值底座,新加坡 MGF 展示了自愿框架的演化速度,中国的备案与标识体系则提供了另一种治理范式。对任何一家正在规模化使用 AI 的组织而言,问题早已不是"要不要治理框架",而是"选择哪套组合,以及何时从纸面走向运行时"。数据显示,88% 的组织已经在用 AI,但只有 8% 拥有全面的治理框架——弥合这条落差带的窗口期,正在随着各辖区法规的生效节点而收窄。
本文基于截至 2026 年 8 月的公开信息撰写,仅供一般性参考,不构成法律、合规或投资方面的专业意见;AI 监管态势变化迅速,具体合规义务请以各辖区官方文本与专业法律意见为准。